Article GPT-6 sur Microsoft Foundry : guide destiné aux entreprises pour la mise en production d'agents IA
Article :
GPT-6 sur Microsoft Foundry : Mettre en production des agents d'IA avec une gouvernance et un ROI mesurables
Par Phil Hawkshaw / 8 Oct 2026 / Sujets: Artificial Intelligence (AI)
- Mettre en production l'IA de pointe : GPT-6 Sol et Luna sont désormais disponibles sur Microsoft Foundry, permettant aux entreprises de concevoir et de déployer des agents d'IA autonomes et spécialisés pour gérer des tâches complexes.
- Maîtriser vos coûts et votre gouvernance : Passez de dépenses d'IA spéculatives à une réelle discipline financière. Utilisez les fonctionnalités intégrées de Microsoft Foundry (Model Router, limites de tokens et coupe-circuits de sécurité) pour éviter la dérive des coûts liée à la prolifération des agents (« agent sprawl »).
- Mesurer la valeur métier réelle : Utilisez le nouveau cadre méthodologique ROI pour les agents afin d'associer directement le coût des agents aux résultats opérationnels. L'indicateur clé ne sera plus le « coût par token », mais le « coût par tâche », bien plus pertinent.
- Bâtir sur un socle prêt pour l'entreprise : Déployez ces modèles d'IA avancés au sein de zones de données sécurisées dans l'UE afin de respecter le RGPD et les exigences de localisation des données, le tout sur une infrastructure Azure robuste et managée par des experts.
En début d'année, un CxO me confiait que ses dépenses en IA avaient dépassé le cloud pour devenir la ligne budgétaire technologique à la croissance la plus rapide. Et presque rien de tout cela n'avait été planifié. La raison ? Les tokens : des centaines de millions d'appels vers des modèles de pointe (« frontier models »), exécutés dans des workflows que personne ne surveillait vraiment.
Le 22 septembre dernier, Microsoft a annoncé la disponibilité générale de GPT-6 Sol et GPT-6 Luna dans Microsoft Foundry, complétant ainsi l'offre aux côtés de GPT-6 Astra. Cette annonce majeure rend ce débat à la fois plus facile à aborder... et plus facile à mal appréhender. Plus facile, car l'amplitude tarifaire entre ces trois modèles est telle qu'elle peut transformer la structure de vos coûts. Plus facile à mal appréhender, car la grille tarifaire n'est qu'une infime partie des critères qui déterminent si un agent d'IA parviendra en production et s'y maintiendra à long terme.
Qu’est-ce que Microsoft Foundry ?
Le service Foundry Agent est une plateforme managée permettant de créer, de connecter et de faire évoluer des agents intelligents de manière ouverte, intégrée et prête pour l'entreprise. Elle vous permet d'apporter le framework et le modèle de votre choix, puis de les déployer avec une seule commande sur un runtime managé offrant une isolation des sessions, une gestion native de l'identité et une observabilité intégrée.
Les modèles « Direct from Azure », comme GPT-6 Astra, sont achetés et gérés directement via Azure avec une licence unique, un support cohérent et sans aucune dépendance vis-à-vis de tiers. Ils intègrent une facturation unifiée, une gouvernance centralisée et la portabilité des PTU (Provisioned Throughput Units) entre les modèles, le tout au sein de Microsoft Foundry.
La nouvelle offre : Trois modèles, un rapport de prix de un à cent
Microsoft positionne Astra pour les tâches exigeantes de raisonnement, d'ingénierie logicielle et d'interaction système (« computer use »), Sol pour les tâches de production générales, et Luna pour l'extraction à grand volume, la synthèse et l'aiguillage (« routing »). Tous trois sont disponibles en déploiement Standard au sein des zones de données UE (Europe) et US (États-Unis), ainsi qu'à l'échelle mondiale. Voici les tarifs applicables pour la zone de données européenne (EU Data Zone) :
GPT-6 Astra vs Sol vs Luna
| Indicateur | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
| Input, par million de tokens | 12,00 $ | 2,40 $ | 0,12 $ |
| Output, par million de tokens | 60,00 $ | 12,00 $ | 0,60 $ |
Astra coûte 100 fois plus cher que Luna, en entrée comme en sortie. Sol se positionne à un cinquième du tarif d'Astra. À titre d'illustration, prenons une étape qui lit 2 000 tokens et en écrit 300. Avec ces tarifs, cela revient à environ 0,042 $ sur Astra, 0,0084 $ sur Sol et 0,0004 $ sur Luna. Exécutez cette tâche 100 000 fois par mois, et la facture s'élèvera à environ 4 200 $, 840 $ ou 42 $.
J'ai vu ce même principe à l'œuvre au sein de nos propres équipes d'ingénierie. Nous avons analysé environ 90 000 documents contractuels du gouvernement britannique à l'aide de quatre GPU sur site (« on-premises »). Un agent de codage de pointe (« frontier agent ») a conçu le pipeline de traitement. Des modèles plus modestes, hébergés sur notre propre matériel, se sont chargés de l'intégralité de la lecture. Ce choix d'architecture a été dicté par des contraintes réglementaires sur les données plutôt que par les coûts, mais la logique reste identique : le modèle le plus onéreux gère la réflexion complexe qui l'exige, tandis que les modèles plus économiques absorbent le volume.
Coût par tâche : Une mesure pertinente, mais incomplète
Les recommandations de Microsoft invitent à dépasser la simple notion de coût par token pour se concentrer sur le coût par tâche. Je partage pleinement cette vision, et j'irais même un peu plus loin : le coût d'une tâche se compose de trois éléments : les tokens, le calcul (« compute »), et la supervision humaine requise. Les tokens apparaissent bien sur la facture. La supervision humaine, quant à elle, y figure rarement.
Un modèle plus économique qui génère un volume important de corrections manuelles de la part de vos collaborateurs peut finalement coûter plus cher par tâche finalisée qu'un modèle plus performant mais plus onéreux, dès lors que l'on intègre le temps passé par vos équipes. De même, une tâche exécutée à moindre coût et sans erreur peut s'avérer totalement inutile si elle ne répond à aucun besoin réel. Le coût par tâche vous indique ce que coûte une opération. Il ne vous dit pas si elle a créé de la valeur pour vos clients ou vos métiers, et c'est pourtant précisément la question qu'un Directeur Financier finira par poser.
Pour y répondre, un bon outil de routage de modèles ne suffit pas. Il faut structurer l'environnement qui entoure ces agents.
L'architecture : Quatre volets, et le modèle n'est que l'un d'eux
Au cœur de l'AI Centric Enterprise Architecture Framework d'Insight se trouve une image simple, semblable aux structures de pierre que l'on observe à Stonehenge : deux piliers verticaux, un linteau posé à leur sommet, et le sol sur lequel repose l'ensemble. Chaque élément supporte une partie de la charge et remplit une fonction bien distincte.
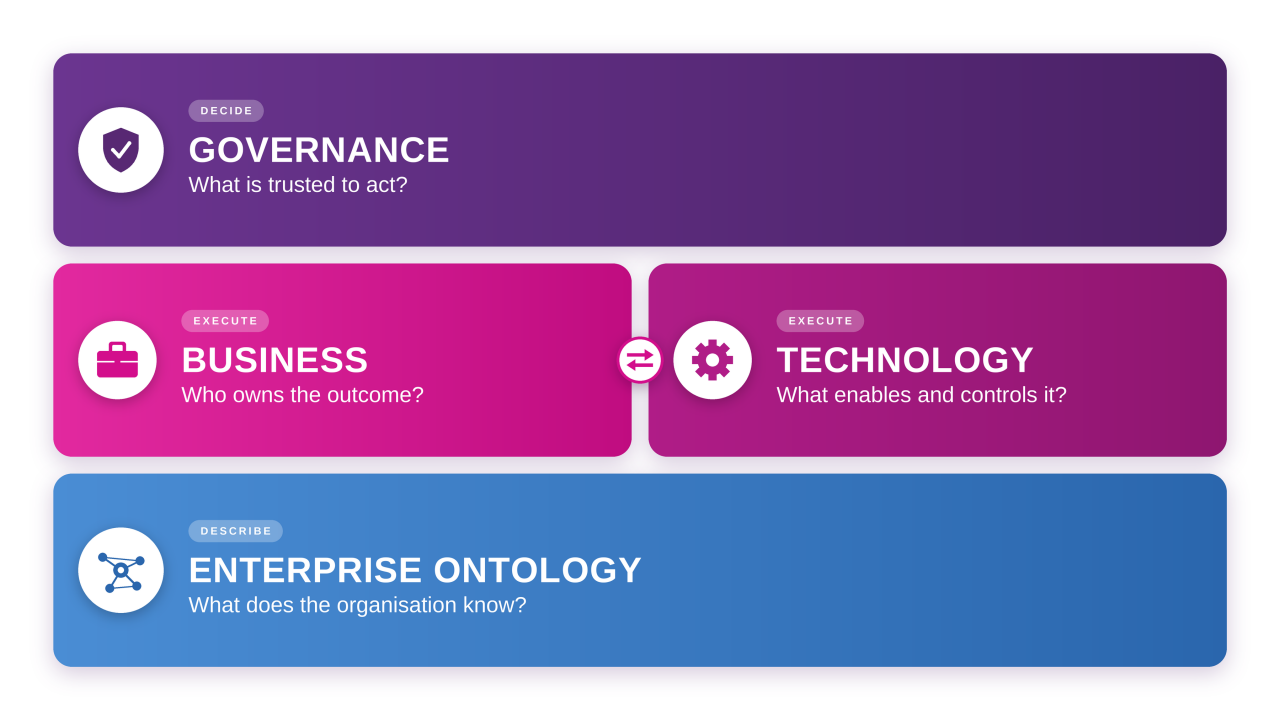
L'un des piliers est la technologie : le patrimoine technologique sur lequel s'exécutent les agents, de l'infrastructure jusqu'à l'expérience utilisateur. C'est là que se positionnent Foundry, Azure et Agent 365, formant des montants solides. L'autre pilier est le volet métier : les rôles et les processus, c'est-à-dire qui réalise le travail, qui en est responsable, et comment les tâches évoluent à mesure que l'IA en prend en charge une part croissante. La gouvernance constitue le linteau reliant ces deux piliers, déterminant ce qui est construit, à qui cela appartient, et le degré d'autonomie accordé à chaque fonctionnalité. Enfin, le socle est la connaissance : une modélisation formelle du savoir de l'entreprise, à travers laquelle chaque agent accède aux données sous-jacentes.
Dans bon nombre de mes échanges, les efforts se sont d'abord concentrés sur le pilier technologique. C'est compréhensible, car c'est là que se matérialisent les démonstrations. Pourtant, l'essentiel de ce qui détermine la réussite d'une mise en production repose sur les trois autres volets. Quatre questions clés permettent d'en identifier les enjeux.
01
À qui incombe la responsabilité de chaque agent ?
+
À qui incombe la responsabilité de chaque agent ?
Un agent est titulaire d'un rôle, pas une simple technologie. Il possède une fiche de poste, une position au sein de l'organisation et un ensemble de responsabilités, qu'il s'exécute de manière autonome au sein d'un processus (« headless ») ou qu'il assiste un collaborateur en tant que copilote. La question est de savoir si l'entreprise a clairement défini ces éléments ou si elle a laissé le concepteur de l'agent les déduire de lui-même. Une console de supervision (« control plane ») peut vous indiquer quels agents existent et à quelles ressources ils ont accès. Désigner la personne garante de chacun d'eux relève d'une décision métier, et cette responsabilité doit rester humaine à tous les niveaux d'autonomie.
02
Quel niveau d'autonomie chaque étape a-t-elle mérité ?
+
Quel niveau d'autonomie chaque étape a-t-elle mérité ?
Il est utile d'évaluer chaque étape faisant intervenir l'IA sur une échelle de 1 à 5. À une extrémité, l'IA n'intervient pas. À l'étape suivante, l'humain effectue le travail et utilise l'IA comme un simple outil. Au milieu, l'IA réalise elle-même certaines étapes, tandis qu'un humain continue de coordonner l'ensemble et de résoudre les anomalies. Plus loin encore, l'IA coordonne un mix d'agents d'IA et de collaborateurs humains. À l'extrême opposé, les humains n'interviennent que lorsque le système s'interrompt. La différence entre ces niveaux réside dans les tâches prises en charge par l'IA, et non dans l'attribution de la responsabilité finale.
Pour qu'une étape gagne un niveau sur cette échelle, il faut apporter la preuve d'une double maturité, technique et métier : qualité démontrée, mode de défaillance acceptable, piste d'audit, règles d'escalade éprouvées et validation formelle de l'équipe garante du résultat final. Le temps écoulé ne constitue en aucun cas un critère suffisant. Une étape peut également être rétrogradée, ce qui témoigne de la régulation efficace du système et non d'un dysfonctionnement. Les fonctionnalités d'évaluation et de traçabilité de Foundry fournissent l'essentiel de ces preuves. Déterminer si ces éléments sont suffisants reste un arbitrage métier ; d'ailleurs, le purgatoire des projets pilotes découle bien souvent du fait que personne n'a préalablement défini ce que signifie être « prêt ».
03
Que sait l'agent ?
+
Que sait l'agent ?
N'importe lequel de vos concurrents peut acquérir GPT-6 le même jour et au même tarif que vous. En revanche, ce qu'il ne peut pas acheter, c'est une description de ce que représente un « client » pour votre entreprise, des règles qui régissent vos contrats ou de la source de données faisant autorité pour fixer vos tarifs. Un agent agit sur la seule base de ce qu'il récupère. En l'absence de source désignée comme faisant autorité, il peut tout à fait extraire une définition obsolète et s'y conformer avec la même assurance que s'il s'agissait de la bonne. Les modèles s'achètent. La compréhension se construit.
04
Où résident les données, et qui a pris cette décision ?
+
Où résident les données, et qui a pris cette décision ?
La localisation des données (« data residency ») illustre parfaitement l'impact financier d'un arbitrage architectural. Les tarifs de la zone de données européenne (EU Data Zone) présentés ci-dessus sont supérieurs de 20 % à ceux de l'offre Global Standard pour les trois modèles. Lorsque des réglementations telles que le RGPD, NIS2 ou DORA imposent un traitement au sein de l'UE, ce surcoût est pleinement justifié. En revanche, lorsque ce choix relève d'une simple préférence plutôt que d'une obligation réglementaire, il doit être étayé par une justification claire et porté par un responsable désigné. Traiter chaque charge de travail comme étant soumise à cette obligation revient à s'acquitter d'un surcoût injustifié. À l'inverse, ignorer ces contraintes expose l'entreprise à découvrir une exigence de résidence des données une fois le développement finalisé. Notre article sur la souveraineté du cloud et la conformité en Europe aborde de manière détaillée l'ensemble de ces aspects réglementaires.
Ce que fait Insight : Démarrer à partir de l'existant
La première discussion porte rarement sur un nouveau modèle. Elle concerne plutôt ce qui est déjà opérationnel : des agents conçus par une équipe au trimestre précédent, des fonctionnalités d'IA activées au sein de logiciels acquis par l'entreprise il y a plusieurs années, ou des outils adoptés sans que personne n'ait été consulté. Notre démarche commence par l'identification de ces éléments, le positionnement de chaque étape sur notre échelle d'évaluation et la désignation d'un responsable.
À partir de là, Insight accompagne votre transition de l'expérimentation vers la production par étapes. Nous nous appuyons sur notre AI Centric Enterprise Architecture Framework et tirons parti de nos Agentic Enterprise Accelerators. La maturité technique et la viabilité métier sont systématiquement validées de concert avant tout déploiement :
- Choisir les modèles sur la base de preuves factuelles. Nous évaluons les performances d'Astra, Sol et Luna par rapport aux tâches spécifiques de votre entreprise au sein de Foundry, afin de modéliser précisément les coûts de chaque cas d'usage, y compris la part liée à la supervision humaine.
- Valider avant de déployer à grande échelle. Les nouvelles fonctionnalités s'exécutent d'abord en parallèle des processus existants, ce qui permet de comparer les résultats directement sur les données réelles de l'organisation avant tout transfert de responsabilité.
- S'accorder sur les bases de connaissances des agents. Avant de connecter les agents à vos données, nous collaborons avec vos équipes métiers pour définir quelles sources font autorité et clarifier la sémantique propre à votre entreprise. Nos Agentic Enterprise Accelerators facilitent la création de cette cartographie partagée de l'entreprise, sur laquelle les agents viendront s'appuyer pour ancrer leurs actions.
- Sélectionner les chantiers prioritaires. Nous aidons la direction à hiérarchiser les cas d'usage selon leur valeur, leur faisabilité et leur potentiel de réutilisation. En effet, il est fréquent qu'une même fonctionnalité soit demandée par trois départements différents avec trois vocabulaires distincts, conduisant à trois développements redondants. Nos accélérateurs facilitent cette priorisation ainsi que la gouvernance du déploiement qui en découle.
- Gérer votre patrimoine technologique Microsoft. En tant que partenaire de lancement au premier jour (« Day 1 Launch Partner ») pour Agent 365, Insight aide les entreprises à déployer et administrer le socle Azure, Foundry et Agent 365 sur lequel repose l'ensemble de cette architecture, y compris dans le choix des régions d'hébergement et des règles de résidence des données.
Rien de tout cela ne se substitue à ce que Microsoft a bâti. Le Model Router de Foundry, les limites de tokens et les garde-fous constituent d'excellents contrôles au niveau du pilier technologique, et nous les configurons dans cette optique. Le reste de l'architecture est ce qui donne du sens à ces contrôles pour l'entreprise. Si vous en êtes encore à déterminer par où commencer, notre guide pour surmonter l'écart de mise en œuvre de l'IA constitue un excellent point de départ.
Nouveau paradigme : Même modèle, résultats différents
GPT-6 sera disponible pour vos concurrents le même jour, sur la même plateforme et au même tarif. Ce n'est pas le modèle en soi qui distinguera les agents d'une entreprise de ceux d'une autre. Ce qui fera la différence, ce sont les responsables désignés, les preuves de performance apportées, l'ancrage de la connaissance (« grounding ») et les choix stratégiques liés à la localisation de vos données.
Si vos agents ne reposent encore que sur la réussite d'une démonstration, c'est un excellent point de départ pour engager la conversation.


Phil Hawkshaw
CTO EMEA, Insight